Haber akışına dön
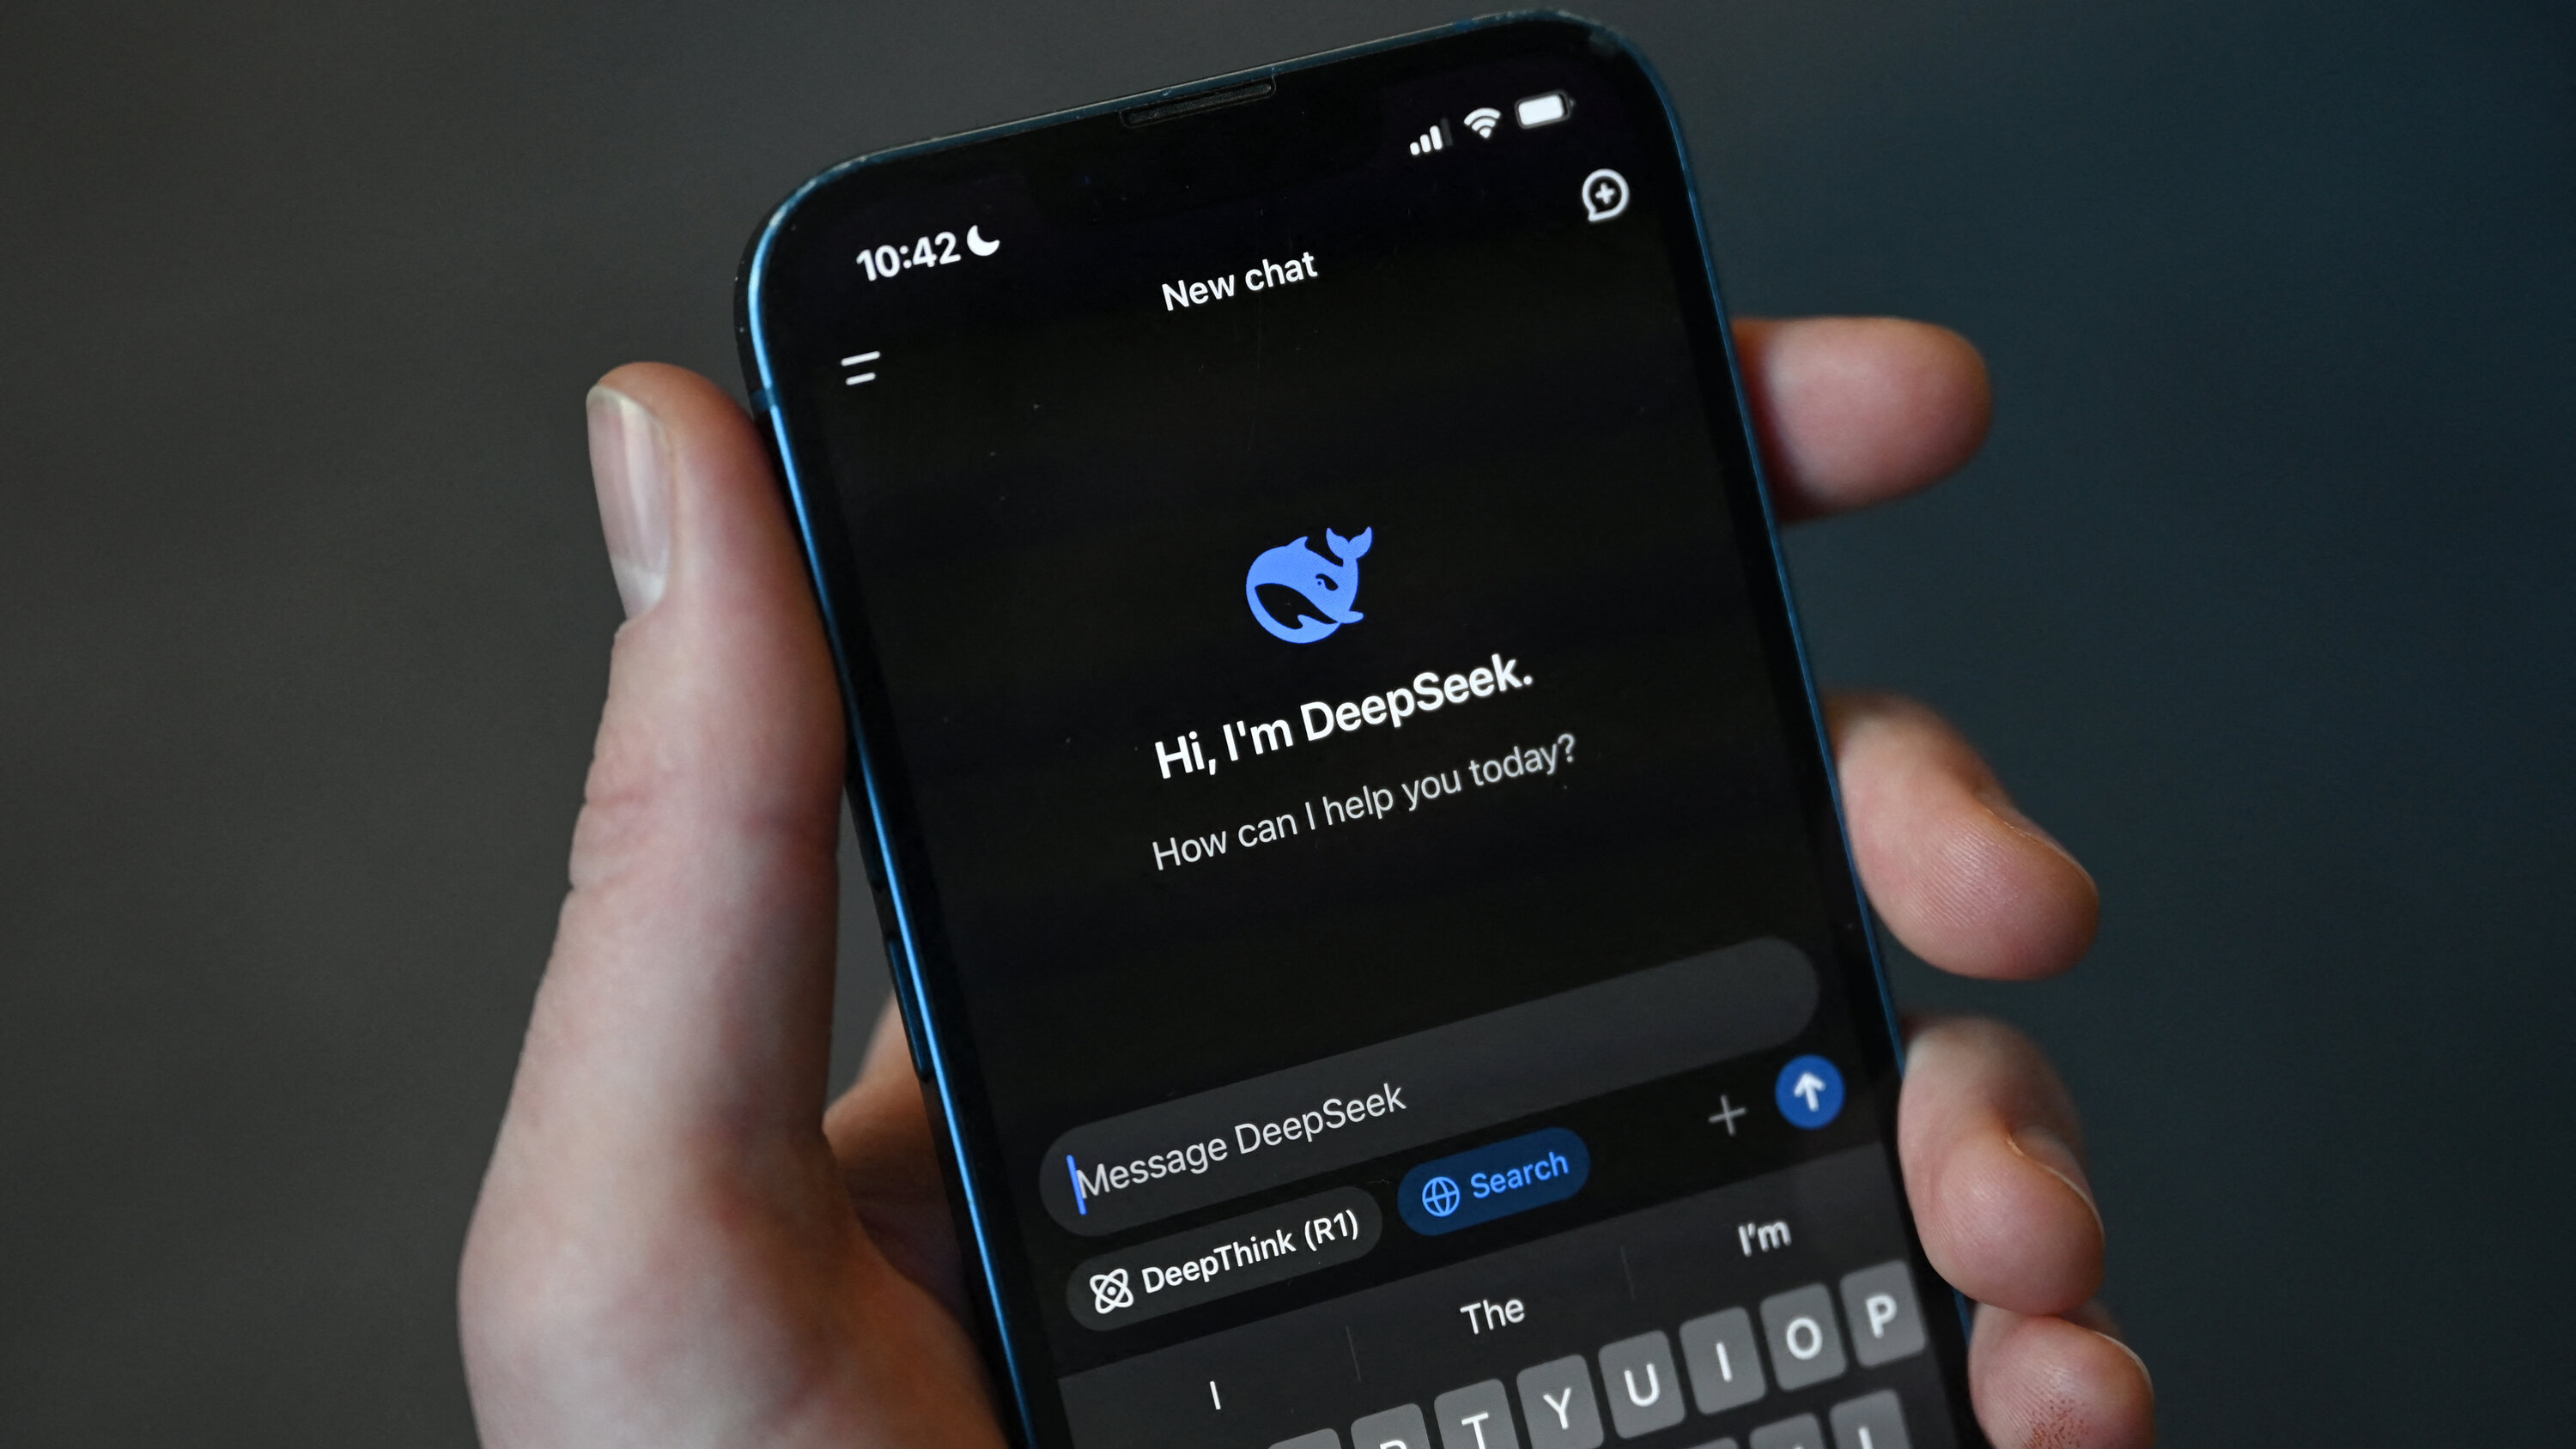
20 Ocak 2025'te, adı pek duyulmamış Çinli bir şirket olan DeepSeek, en yeni yapay zeka modeli olan DeepSeek R1'i piyasaya sürdü ve yapay zeka sektöründe büyük yankı uyandırdı. DeepSeek şirketi, GitHub'a yüklediği bir teknik makalede "açık ağırlıklı" (İng: "open-weight") R1 modelinin, en az OpenAI'ın ChatGPT o1 modeli kadar başarılı olduğunu ve hatta bazı performans değerlendirmelerinde o1'den daha iyi sonuçlar elde ettiğini ilan etti. En çarpıcı olanı ise bu sonuçlara eğitim ve çalıştırma maliyetlerini çok daha düşük tutarak ulaşmayı başarmıştı. R1'in piyasalardaki etkisi de büyük oldu: DeepSeek'in, App Store'da en çok indirilen ücretsiz uygulama haline gelmesiyle ABD'li önde gelen teknoloji şirketlerinin toplam piyasa değerinden 1 trilyon dolar eksildi! Yapay zeka eğitimi için kritik olduğu düşünülen yüksek performanslı H100 grafik çiplerini üreten teknoloji şirketi Nvidia ise, ABD tarihinin en büyük tek günlük kaybıyla 589 milyar dolar değer yitirdi. Nvidia'nın hisselerinin bu denli erimesinin arkasındaki sebep; DeepSeek'in, yapay zeka modellerini bu çipler olmaksızın daha düşük kapasiteli eski Nvidia çipleri kullanarak eğitmiş olmasıydı. ABD'li teknoloji şirketleri bu gelişmelere panikle tepki gösterdi. OpenAI yetkilileri, DeepSeek'in ChatGPT'nin bazı kısımlarını çaldığını bile ima etti.
Yapay zeka uzmanları, DeepSeek'in ortaya çıkışının sektörde ölçeklendirmeye (İng: "scaling") yönelik temel bir anlayışı altüst ettiğini söylemektedir. Keza DeepSeek modeli, daha büyük olmanın her zaman daha iyi olmadığını göstermiştir. Northwestern Üniversitesi'nden bilgisayar bilimi profesörü Kristian Hammond, şöyle söylüyor: "DeepSeek'in daha az maliyetle, daha az hesaplama gücü kullanılarak daha kısa sürede geliştirilebilmiş olması ve normal bilgisayarlarda lokal olarak çalıştırılabilmesi, her zaman daha büyük dil modellerine yönelen ABD sektörünün daha akıllı ve daha küçük ilk modelleri inşa etme fırsatını kaçırdığını göstermektedir."
Peki DeepSeek'in V3 ve R1 modellerini bu kadar çığır açıcı yapan nedir? Bilim insanlarına göre bu sorunun cevabı, verimlilikte saklıdır. Michigan Üniversitesi'nden istatistik ve bilgisayar bilimi profesörü Ambuj Tewari, şöyle söylüyor: "Bir bakıma DeepSeek'in ilerlemeleri devrimsel değil, evrimseldir. Hâlâ çok büyük modeller (yüz milyarlarca parametre), devasa veri setleri (trilyonlarca token) ve bütçelerle çalışıyorlar. Ancak asıl yenilik, bu devasa modelleri diğer sistemler kadar iyi çalıştırırken çok daha az kaynak kullanmalarında yatmaktadır."
Bu yeniliğin anahtarı, modelleri belirli görevlere odaklanan alt modellere bölen "uzman karması" (İng: "mixture-of-experts") sistemidir. Buna ek olarak, diğer modellerin aksine aşırı yüklenen sistemi yavaşlatmak yerine görevleri dinamik olarak daha az meşgul olan alt modellere kaydıran bir yük dengeleme sistemi kullanılmaktadır. Tewari, şöyle söylüyor: "Bu sayede V3 modeli, 671 milyar parametresi olsa da her bir token için yalnızca 37 milyar parametre aktif hale geliyor."
Verimlilik, DeepSeek'in modellerinin eğitimine de yansımaktadır. Uzmanlar bunun, ABD'nin Çin'e olan ihracat kısıtlamalarının beklenmedik bir sonucu olduğunu belirtmektedir. DeepSeek, Çin'in ABD'li şirket Nvidia'nın en gelişmiş H100 çiplerine erişimi kısıtlandırıldığından, modellerini veri transfer hızı düşürülmüş H800 çiplerini kullanarak geliştirdiğini belirtmektedir. Nvidia bu "zayıf" çipi, 2023'te ihracat kısıtlamalarını aşmak için özel olarak tasarlamıştır.
Daha düşük performanslı çipler, DeepSeek'i bir başka önemli atılım daha yapmaya zorlamıştır. Bu atılım, "karışık hassasiyet çerçevesi" (İng: "mixed precision framework") olarak adlandırılmaktadır. Modelin ağırlıklarını (yapay zekanın yapay sinirleri arasındaki bağlantı gücünü belirleyen sayılar) tamamen 32-bit (FP32) yerine, doğruluğun kritik olduğu zor hesaplamalar dışında 8-bit (FP8) ile eğitmiştir. Tufts Üniversitesi'nden teknoloji politikası profesörü Thomas Cao, şöyle söylüyor: "Bu çerçeve, daha az hesaplama kaynağıyla daha hızlı eğitim sağlar. DeepSeek ayrıca veri yükleme, paralelleştirme stratejileri ve bellek optimizasyonu gibi eğitim sürecinin neredeyse her adımını iyileştirerek pratikte çok yüksek bir verimlilik elde etmeyi başarmıştır."
Sonuç olarak, tüm bunlar, şaşırtıcı derecede verimli olan iki model ortaya çıkarmıştır. Rakip modellerin eğitim maliyetleri on milyonlarca dolardan yüz milyonlara çıkmaktadır. Öte yandan DeepSeek, V3 modelini 2 ayda yalnızca 5,58 milyon dolar'a eğittiğini beyan etmektedir. DeepSeek'in V3 modelini çalıştırma maliyeti de benzer şekilde çok daha düşük olarak açıklanmıştır. Bu beyanlara göre eğitimi, Anthropic'in Claude 3.5 Sonnet modelinden 21 kat daha az maliyetle tamamlanmıştır.
Genel olarak uzmanlar, DeepSeek'in kazandığı popüleritenin sektör için olumlu olduğunu, kaynak maliyetlerini düşürerek araştırmacılar ve daha küçük firmalar için ileri yapay zeka araştırmalarına giriş engelini azalttığını belirtmektedir. Bu durum, Nvidia dışında daha fazla çip üreticisinin yarışa katılmasına da alan açabilir. Ancak bu, beraberinde bazı önemli riskler de getirmektedir. Cao, şöyle söylüyor: "Ucuz ve verimli yapay zeka yöntemleri yaygınlaştıkça, Dünya çapında daha fazla araştırmacı ve aktör ileri düzey modeller geliştirebilir. Bu bilimsel ilerlemeyi hızlandırabilir ancak aynı zamanda devletler ve diğer aktörlerin gelişmiş yapay zeka modellerini kötüye kullanma riski, ABD-Çin rekabetinin de ötesinde yeni regülasyon zorlukları doğurmaktadır."