 Haber akışına dön
Alibaba, Qwen4-Max'i 16 Kasım'da genel kullanıma açtı. 1 milyon jetonluk bağlam var ve Qwen, görev maliyetinin 4,43 dolardan 1,67 dolara indiğini söylüyor.
Teknoloji·
Qwen4-Max, Görev Maliyetini Yüzde 62 Kesti
Kaynak:
Alibaba'nın Qwen ekibi, Qwen4-Max'i 16 Kasım 2026'da, 05:01 TSİ'de genel kullanıma açtı. Model artık QwenCloud API'sinde, Token Plan'da, Qwen Studio, QwenWork ve Qoder'da kullanılabiliyor. 11 Kasım'daki qwen4-max-preview sürümü yalnızca Token Plan'daydı ve ödedikçe kullanıma açık değildi.
Qwen ekibi duyuruyu X'te şöyle paylaştı:
Meet Qwen4-Max, your new AI teammate for work, creativity, and discovery!16 Kasım 2026
Meet Qwen4-Max, your new AI teammate for work, creativity, and discovery!
Qwen'in lansman yazısına göre model yeni Qwen4 mimarisi üzerine kurulu. 2,4 trilyon omurga parametresi var. Jeton başına 71 milyar parametre devreye giriyor. Buna ek 328 milyar N-gram Embedding parametresi ekleniyor. Yerel görme (native vision) var. Bağlam penceresi (context window) 1.000.000 jeton.
Qwen4-Max neden şimdi öne çıkıyor?
Asıl haber, yalnızca yeni bir model adı değil. API'nin ödedikçe kullanıma açılması ve fiyatın düşmesi. Alibaba Cloud Model Studio fiyat tablosunda qwen4-max, Singapur uluslararası listesinde milyon jeton başına 1,5 dolar girdi ve 4,5 dolar çıktı. Aynı tabloda Qwen3.8-Max 2 dolar ve 6 dolar. Bu, girdi ve çıktıda yüzde 25 daha düşük liste fiyatı demek.
Örtük önbellek (implicit cache) okuması milyon jeton başına 0,075 dolar. Qwen, bu kalemin Qwen3.8-Max'e göre yüzde 70 daha düşük olduğunu söylüyor. Açık önbellek (explicit cache) yazımı 5 dakikalık seçenekte 1,875 dolar, 1 saatlikte 3 dolar. Okuma yine 0,075 dolar.
Qwen'in kendi Work360 testinde görev başına ortalama maliyet 4,43 dolardan 1,67 dolara iniyor. Bu yüzde 62'lik bir düşüş. X paylaşımı aynı iç testi "yüzde 50'ye kadar daha az jeton" ve "görev maliyetinde yüzde 60'ın üzerinde düşüş" diye özetledi. Blogdaki rakamlar daha net.
Mimari ve bağlam penceresi ne vaat ediyor?
Qwen4-Max, uzmanların karışımı (mixture-of-experts, MoE) bir model. Blog, dikkat, artık bağlantılar (residual connections) ve gömüleri (embeddings) yenilediklerini yazıyor. GDN + Qwen Sparse Attention (QSA), Gated Residual (GR) ve N-gram Embedding bu yeniliğin üç parçası.
QwenCloud belgelerine göre düşünme kapalıyken azami çıktı 131.072 jeton. Düşünme açıkken düşünme ve son yanıt birlikte 262.144 jetona kadar çıkabiliyor. Varsayılan düşünme bütçesi 131.072 jeton. Düşünme varsayılan olarak açık; Chat Completions için varsayılan çaba düzeyi high.
Model metin, görüntü ve video anlayabiliyor. İşlev çağırma (function calling), yapılandırılmış çıktı, web araması, PDF, kod yorumlayıcı ve MCP (Model Context Protocol) destekleniyor. İnce ayar (fine-tuning) ve model dağıtımı yok. Toplu çıkarım (batch inference) de desteklenmiyor.
Qwen'in testleri ne gösteriyor?
Work360, Qwen'in karmaşık iş senaryoları için kurduğu çerçeve. 26 birinci kademe alan, 182 ikinci kademe alt alan ve 721 üçüncü kademe uzmanlık var. Bu iç testte Qwen4-Max 52,69, Qwen3.8-Max 47,74 puan almış.
Jeton kullanımı da düşüyor, yine Qwen'in ölçümüne göre. Work360'te Xhigh çabada yaklaşık yüzde 24, High çabada yaklaşık yüzde 35 daha az jeton harcanıyor. Terminal-Bench 4.0'da düşüş yaklaşık yüzde 48 ve yüzde 49. Bunlar şirketin kendi değerlendirmesi.
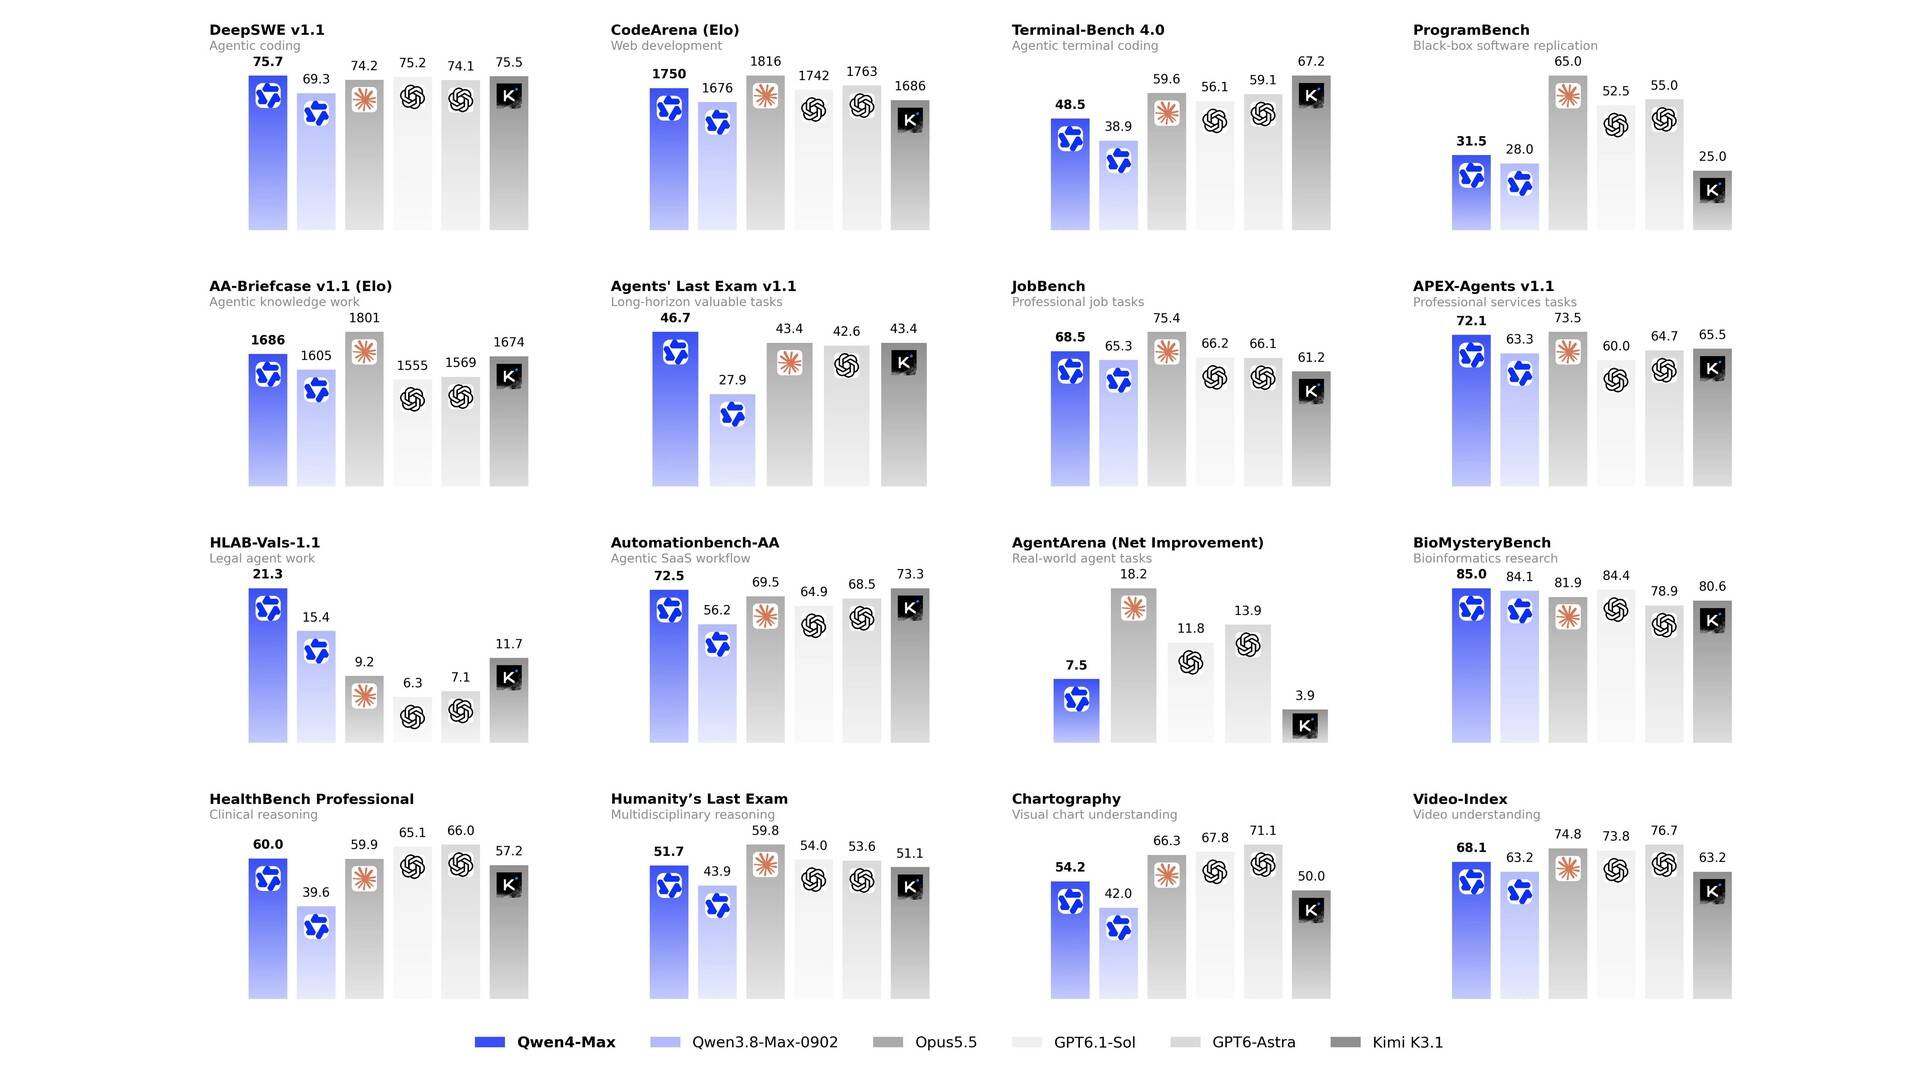
Duyuru görseli, Qwen4-Max'i Qwen3.8-Max-0902, Opus 5.5, GPT-6.1-Sol, GPT-6 Astra ve Kimi K3.1 ile yan yana koyuyor. Model her testte birinci değil. Qwen'in slaydına göre DeepSWE v1.1'de 75,7 (önceki 69,3), HealthBench Professional'da 60,0 (önceki 39,6), HLAB-Vals-1.1'de 21,3 puan alıyor. Terminal-Bench 4.0'da ise 48,5 puan var. Aynı slaytta Kimi K3.1 67,2, Opus 5.5 59,6.
Qwen ekibi aynı gün kendi X hesabından ek notlar da düştü. Code Arena WebDev'de 6. sıraya çıktıklarını ve Qwen3.8-Max'e göre 74 puan yükseldiklerini yazdı. Agent Arena'da önceki Max'e göre yüzde 7,5 net artış ve Alibaba'nın laboratuvar sıralamasında 5. sırada olduğunu söyledi. Image-to-WebDev Arena'da 1.674 puanla 6. sıradalar; önceki Max 1.639 puandaydı. DesignArena'da Python-PPTX 4., Spreadsheet 5. sırada. Model ayrıca OpenRouter'da açıldı. Bu notlar ekibin kendi paylaşımı.
Türkiye'den nasıl kullanılır?
QwenCloud bölge listesinde Türkiye veya İstanbul yok. Avrupa için Frankfurt var. Diğer seçenekler Singapur, Hong Kong, Tokyo, Pekin ve ABD Virginia. Belgeler, Pekin ile Global fiyatlarının aynı, Singapur'un ayrı olduğunu belirtiyor.
API, OpenAI Chat Completions, Responses, Anthropic Messages ve DashScope biçimleriyle uyumlu. Birçok geliştirici aracı bu yüzden ek ayarla bağlanabilir. Singapur'daki ödedikçe kullan çağrılarında 1 milyon ücretsiz jeton da var. Bu kota, Token Plan kredisinden ayrı.
Qwen4-Max'in kendisi açık ağırlıklı değil. Hugging Face veya GitHub'da bu model için ağırlık yayını yok. Blog ve X, ailedeki daha küçük modellerin açık ağırlıklarının geleceğini söylüyor. Tarih ve boyut vermiyorlar. Yerelde kurulum da yok; ince ayar ve dağıtım desteklenmiyor.
Blogda üretim, hukuk, finans ve laboratuvar vitrinleri de var. Örneğin SANF ve Pacific Union örneklerinde tek parça programlama süresinin yaklaşık 475 dakikadan 24 dakikaya, yani yüzde 95 düştüğü anlatılıyor. Bunlar şirket vitrini. Bağımsız bir ölçüm değil. Türkiye'de modeli kullanmaya başlayan bir şirket adı da henüz doğrulanmadı.
Sık sorulan sorular
Qwen4-Max ücretsiz mi?Hayır, ödedikçe kullanılan bir API. Singapur'da 1 milyon jetonluk ücretsiz kota var. Token Plan ayrı bir abonelik.
11 Kasım'daki önizlemeden farkı ne?qwen4-max-preview yalnızca Token Plan'daydı. Önizleme 11 Kasım 10:00 ile 25 Kasım 24:00 (UTC+8) arasında. 16 Kasım'da açılan qwen4-max, ayrı bir model kimliği ve ödedikçe kullanıma açık.
Türkiye'den erişilir mi?Türkiye bölgesi listede yok. Frankfurt ve Singapur seçenekleri var. API, OpenAI ve Anthropic biçimleriyle uyumlu.
Model açık ağırlıklı mı?Hayır. Qwen, daha küçük Qwen4 modellerinin açık ağırlıklarını ileride yayımlayacağını söylüyor. Tarih yok.
İlgili içerikler
Sağlıkta yapay zekanın kalbi Las Vegas'ta atıyor: HLTH 2026'da Apple, OpenAI ve bir Türk girişimi
Sabancı, elektrifikasyona 6 milyar dolar yatırdı
Elektrik fiyatında zirve Bermuda, Türkiye 109.
Haberde hata mı var?Bize bildirin
Senin fikrin ne?
Sen iş akışında Qwen3.8-Max yerine Qwen4-Max'i kullanır mıydın, yoksa maliyet farkı senin için yeterince büyük mü?
Yorumlar
İlk yorumu siz yazın.
Okumaya devam et

GÜNDEM Haber Global·
Erzurum'da Korkutan Deprem
Erzurum'un Pasinler ilçesinde saat 06.01'de 3.6 büyüklüğünde deprem meydana geldi.
Haber Global·